AI 소설 쓰기 실험: 작업을 나누자 출력이 6~7배 길어졌다
결론부터: 최대 출력 토큰은 실제 출력 길이가 아니었다
GPT-4o mini에 최대한 긴 소설을 요청했지만 결과는 약 1,800 토큰에서 끝났다. 당시 API가 허용한 최대 출력 16,384 토큰과는 큰 차이였다. 반면 같은 주제를 개요 작성, 장별 집필, 평가, 재작성으로 나눈 LangGraph 워크플로우에서는 단일 호출보다 약 6~7배 긴 결과가 나왔다.
여기서 확인한 것은 “에이전트가 소설을 더 잘 쓴다”가 아니다. 출력 길이는 늘었지만 작품의 품질과 일관성을 객관식 평가나 반복 실험으로 측정하지 않았다. 이 글은 한 번에 길게 쓰게 하는 방식보다 작업을 나누는 편이 길이와 구조를 제어하기 쉬웠다는 개발 기록이다.
기준선: 단일 API 호출
기준선은 Streamlit으로 만든 간단한 화면에서 GPT-4o mini를 한 번 호출하는 방식이었다. 프롬프트에는 세계관, 인물, 플롯, 장면과 장 구성을 모두 포함해 가능한 한 길게 써 달라고 요청했다.
사용한 프롬프트
초기 프롬프트는 Claude 3.5 Sonnet으로 초안을 만든 뒤 그대로 사용했다.
당신은 세계적으로 유명한 베스트셀러 작가입니다. 당신의 작품은 풍부한 세계관, 복잡한 캐릭터 발전, 그리고 흥미진진한 플롯으로 유명합니다. 지금 당신에게는 새로운 장편 소설을 쓸 기회가 주어졌습니다.

주제: {topic}

이 주제를 바탕으로 최대한 길고 상세한 소설을 써주세요. 다음 가이드라인을 따라주세요:

1. 풍부한 세계관 구축: 소설의 배경이 되는 세계를 상세히 묘사해주세요. 역사, 문화, 사회 구조, 기술 수준 등을 포함해주세요.
2. 다양하고 깊이 있는 캐릭터: 주요 등장인물들의 배경, 성격, 동기, 내적 갈등을 자세히 발전시켜주세요.
3. 복잡한 플롯 구조: 여러 개의 서브플롯을 포함한 복잡하고 흥미로운 이야기를 만들어주세요. 예상치 못한 반전도 포함시켜주세요.
4. 상세한 장면 묘사: 각 장면을 생생하게 묘사해주세요. 감각적인 세부 사항을 포함하여 독자가 그 장면 속에 있는 것처럼 느끼게 해주세요.
5. 다양한 문체 활용: 서술, 대화, 내적 독백, 회상 등 다양한 문체를 활용하여 이야기를 풍부하게 만들어주세요.
6. 테마와 상징: 소설 전반에 걸쳐 깊이 있는 테마와 상징을 발전시켜주세요.
7. 장편 구조: 소설을 여러 장(chapter)으로 나누어 구성해주세요. 각 장의 시작에는 간단한 요약이나 인용구를 넣어주세요.

이 가이드라인을 바탕으로, [주제]에 대한 최대한 길고 상세한 소설을 시작해주세요. 당신의 창의력을 최대한 발휘하여, 독자들이 몰입할 수 있는 풍부하고 흥미진진한 이야기를 만들어주세요.
실험 결과
생성된 텍스트는 약 1,800 토큰이었다. 최대 출력 한도를 높여 놓는 것만으로 모델이 그만큼의 텍스트를 채우지는 않았다.
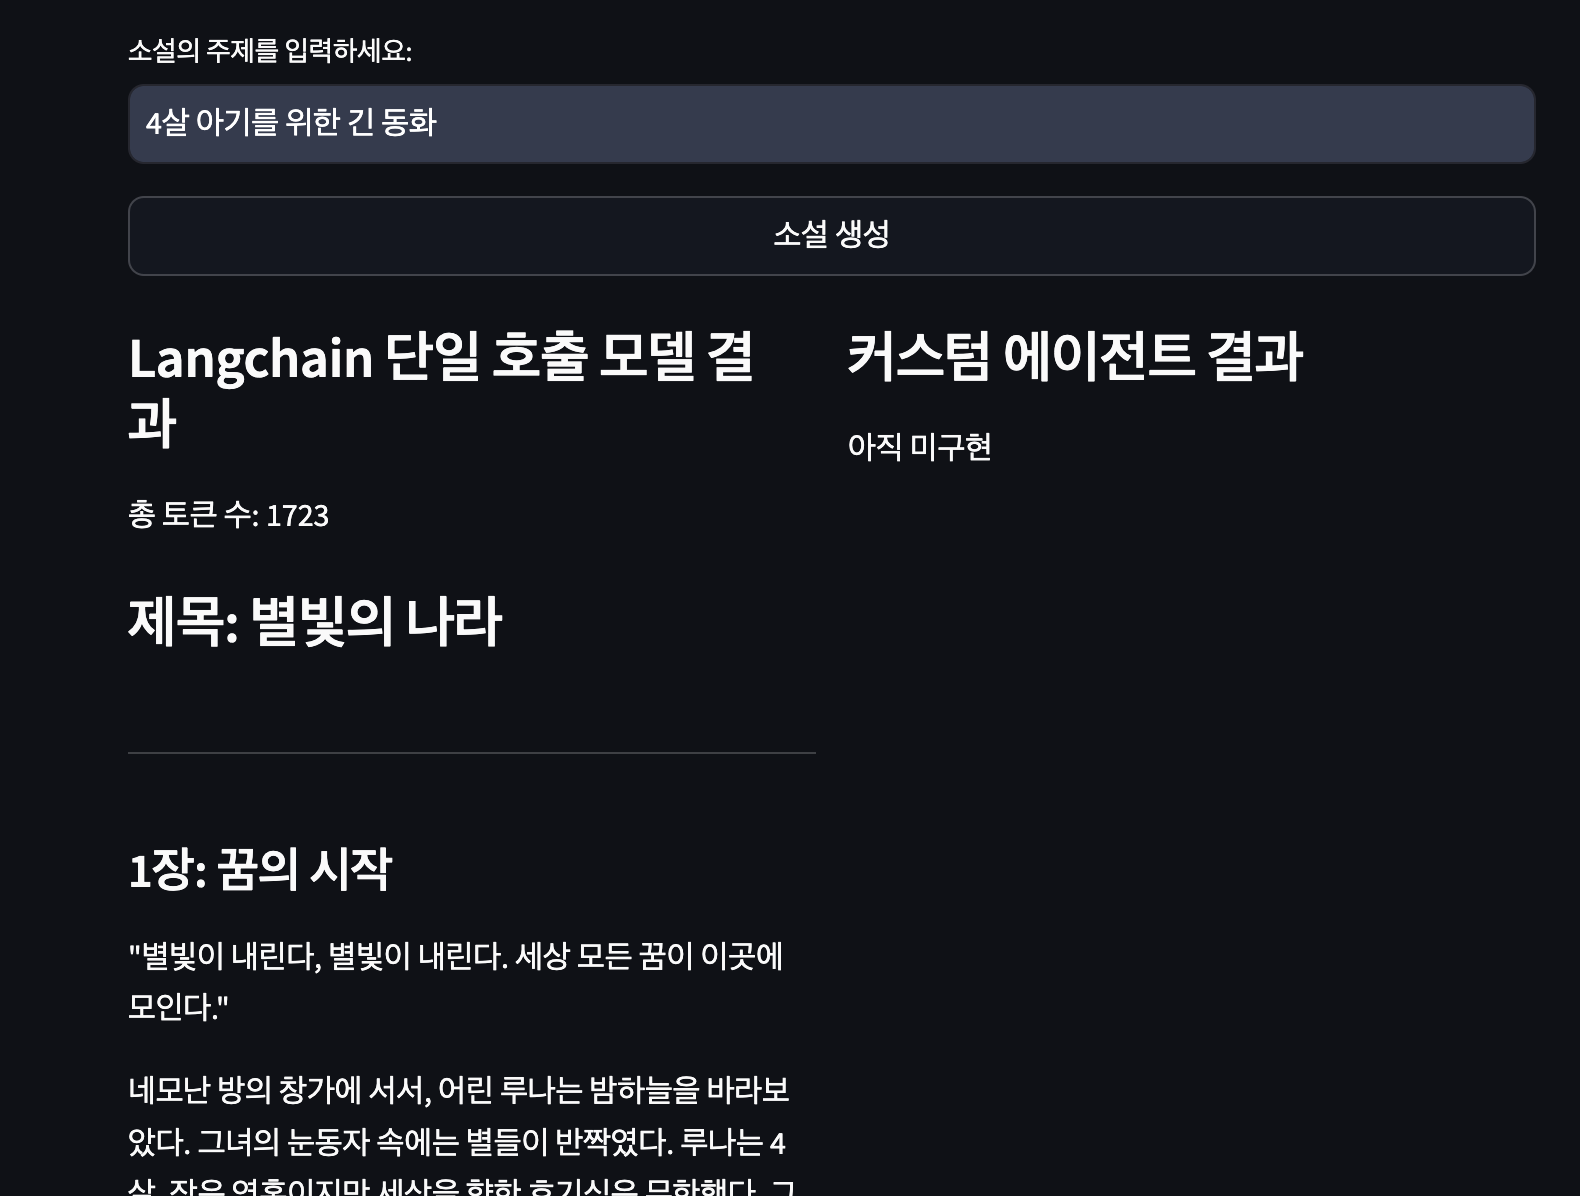
결과 분석
이 결과로 확인한 범위는 좁다.
- API의 최대 출력 한도는 실제 응답 길이를 보장하지 않았다.
- 한 프롬프트에 많은 요구사항을 넣어도 각 요소가 충분히 전개되지는 않았다.
- 이 기록만으로 원인을 모델 학습 방식이나 프롬프트 하나로 단정할 수는 없다.
다음 실험에서는 최대 토큰 수를 더 키우는 대신 집필 과정을 여러 호출로 나눴다.
참고한 접근: LongWriter의 작업 분해
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs는 긴 컨텍스트를 읽는 능력과 긴 답변을 쓰는 능력이 같지 않다는 문제를 다뤘다. 연구진은 먼저 긴 글의 계획을 세우고 하위 작업별로 집필하는 AgentWrite 파이프라인을 제안했다.
비공개 API 모델을 다시 학습할 수는 없었기 때문에 논문의 학습 방법을 재현하지 않았다. 제가 가져온 것은 계획을 먼저 만들고 집필 단위를 나눈다는 아이디어뿐이다. 따라서 아래 결과는 LongWriter 재현 실험이 아니라 LangGraph로 별도 구현한 응용 사례다.
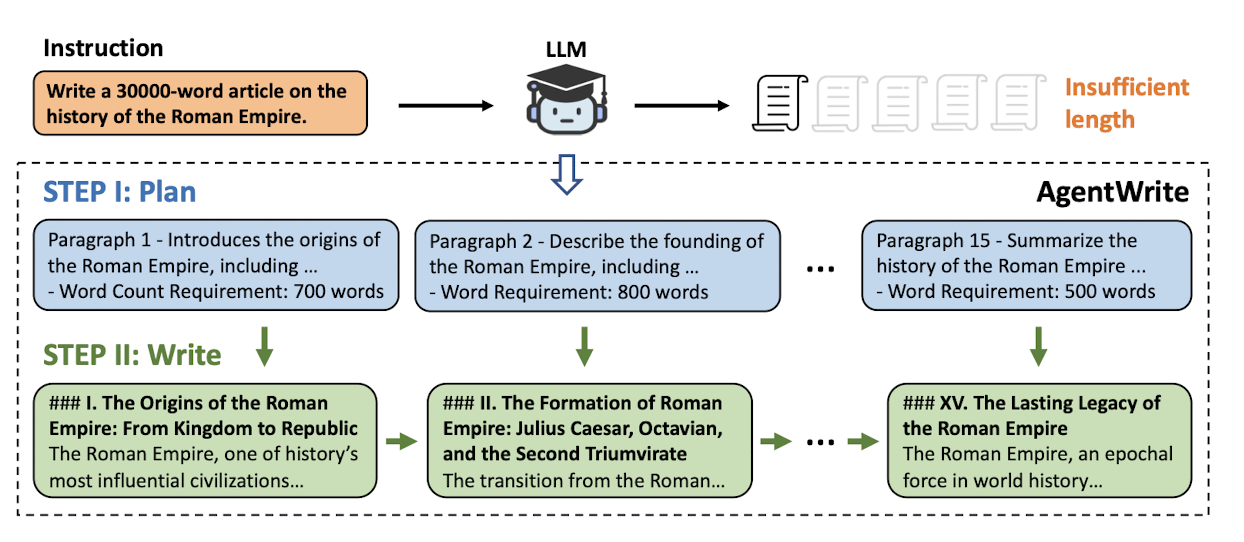
LangGraph로 집필 단계를 나누기
실험 구조
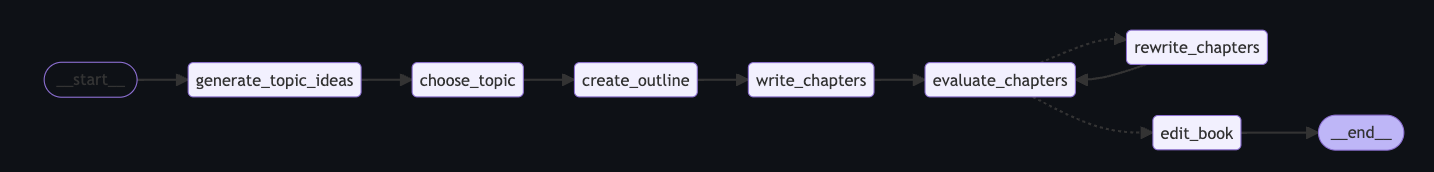
제가 구현한 소설 작성 워크플로우는 다음 일곱 단계로 구성했다.
generate_topic_ideas: 주어지는 독자층을 고려해서 소설의 주제 아이디어를 생성합니다.choose_topic: 생성된 아이디어 중 하나를 선택합니다.create_outline: 선택된 주제를 바탕으로 소설의 개요를 작성합니다.write_chapters: 개요를 바탕으로 각 챕터를 작성합니다.evaluate_chapters: 작성된 챕터들을 평가합니다.rewrite_chapters: 평가 결과에 따라 챕터를 다시 씁니다.edit_book: 2개씩 챕터를 이어서 확인하면서 수정할 부분을 수정해서 글을 확정합니다.
핵심은 장별 집필 전에 전체 개요를 고정하고, 작성 뒤에는 평가 결과를 다음 재작성 호출의 입력으로 넘기는 것이다. 한 호출이 전체 소설을 책임지지 않게 했다.
실험 결과
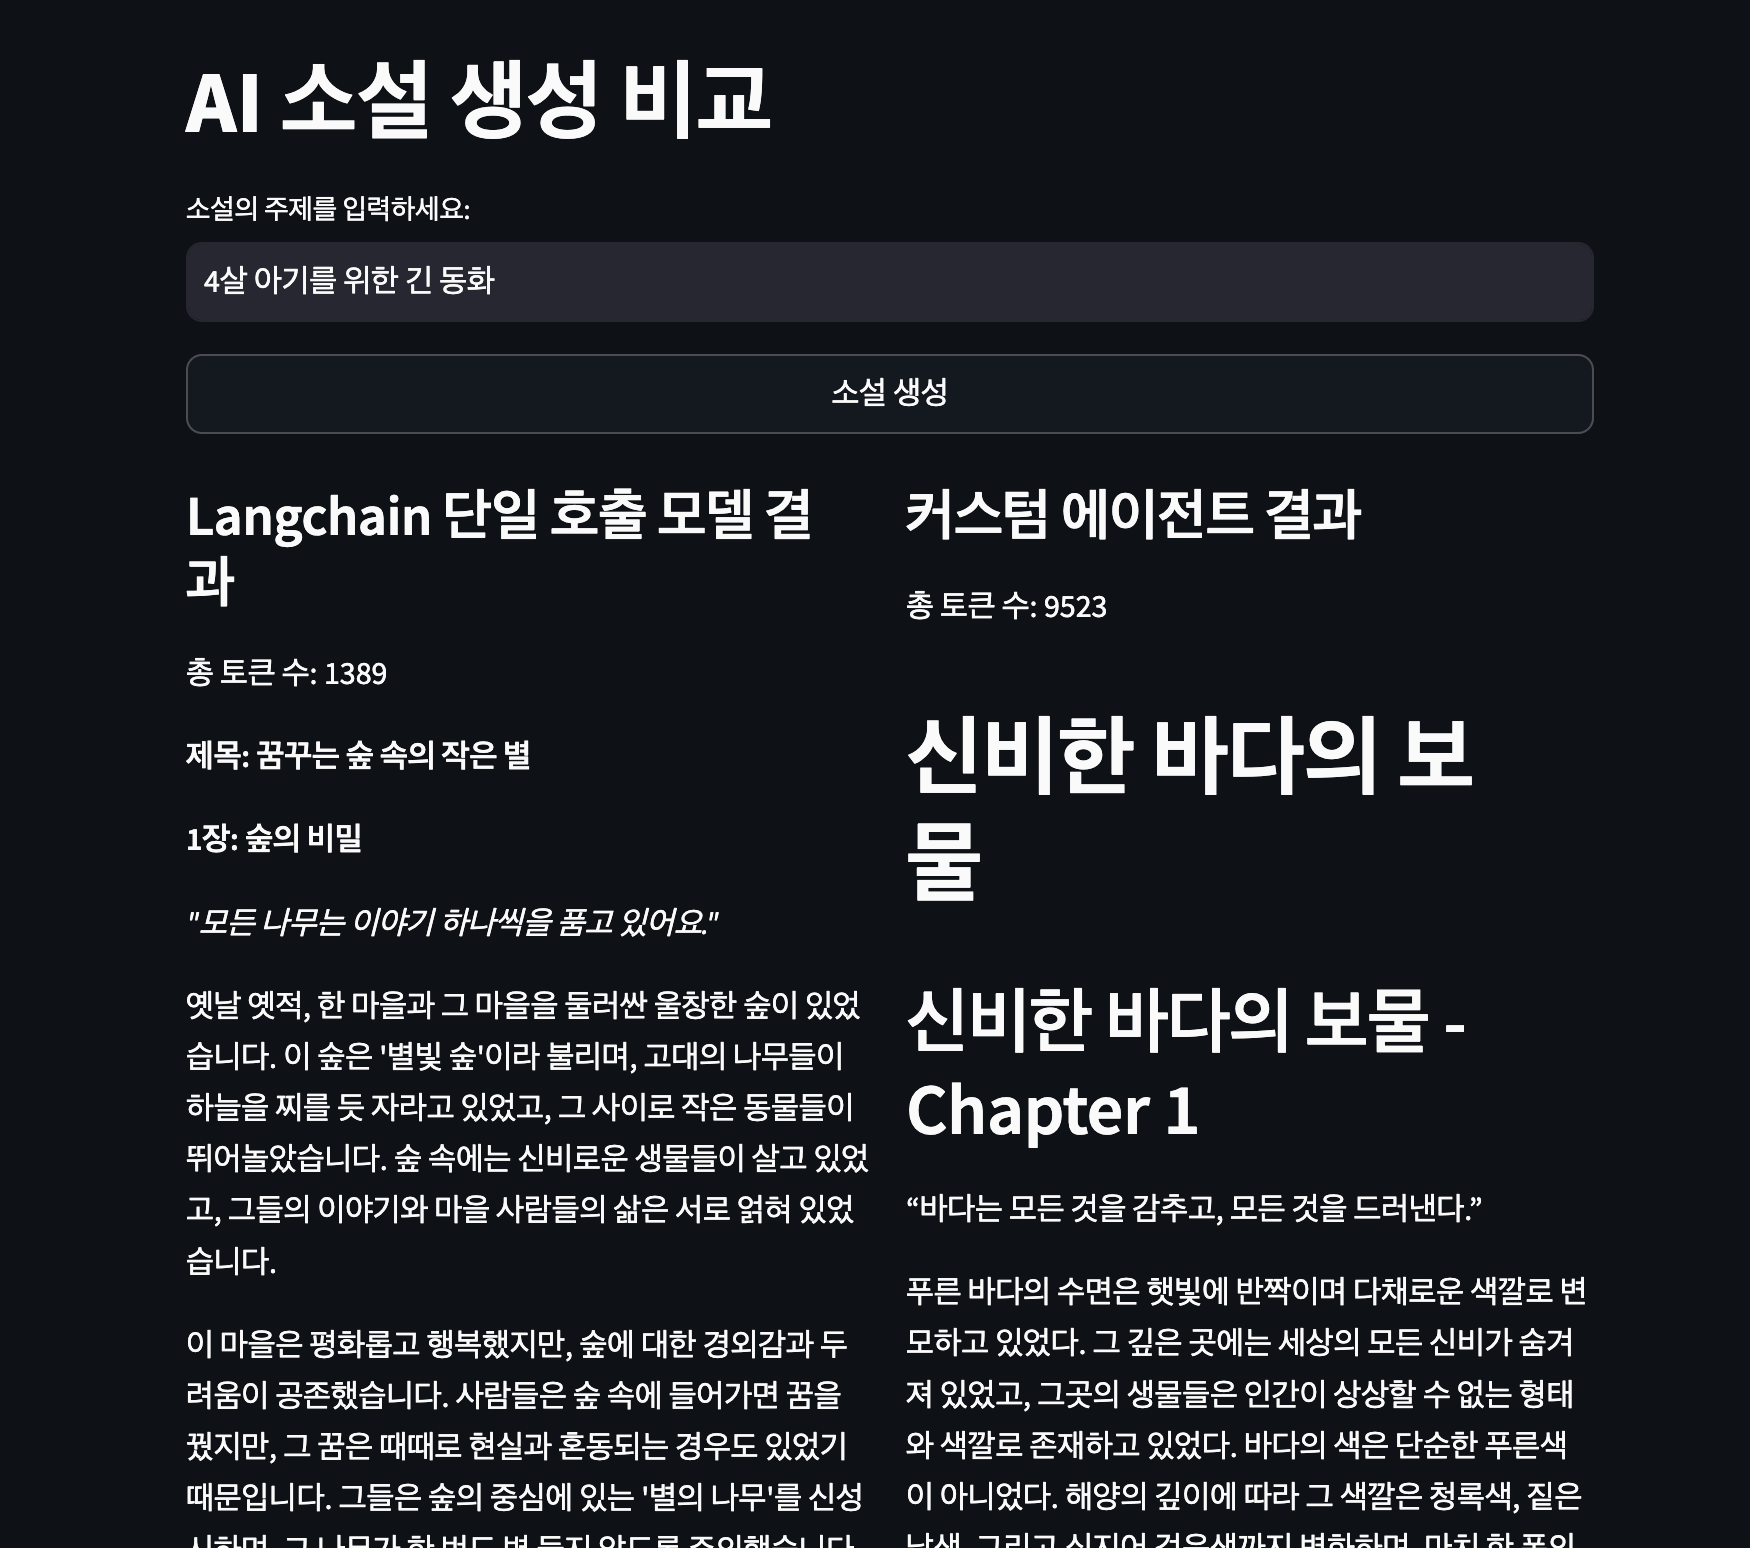
같은 주제를 입력했을 때 단계 분해 방식은 단일 호출보다 약 6~7배 긴 텍스트를 만들었다. 미리 만든 개요를 장별 입력에 반복해서 넣었기 때문에 최소한 장 구분과 전체 순서는 유지하기 쉬웠다.
길이가 늘었다고 품질이 같은 비율로 좋아진 것은 아니다. 다음 조건을 기록하지 않아 재현 가능한 벤치마크라고 부를 수 없다.
- 반복 실행 횟수와 생성 파라미터를 고정하지 않았다.
- 일관성, 문체와 독창성을 평가할 독립된 기준이나 사람 평가가 없었다.
- 평가와 재작성을 같은 계열의 모델에 맡겨 자기평가 편향을 분리하지 못했다.
- 여러 API 호출로 지연 시간과 비용이 늘어나는 정도를 측정하지 않았다.
이 실험 뒤에 바뀐 판단
장문 생성에서 먼저 정해야 할 것은 최대 토큰 수가 아니라 글의 상태를 어디에 보존하고 어느 단위로 작업을 나눌지였다. 전체 개요, 등장인물 설정과 앞 장의 사건을 명시적인 상태로 관리하면 다음 호출이 해야 할 일이 작아진다.
다시 실험한다면 단일 호출과 단계 분해 방식을 같은 주제·파라미터로 여러 번 실행하고, 길이 외에 설정 모순 수, 장별 목표 충족률, 사람 평가와 호출 비용을 함께 비교할 것이다. 지금의 결과는 작업 분해가 긴 출력을 만드는 데 유용했다는 관찰까지는 지지하지만, 더 좋은 소설을 보장한다는 근거는 아니다.
ABOUT THIS ARTICLE
이 글은 직접 실험입니다
단일 API 호출과 LangGraph 기반 작업 분해를 직접 구현해 출력 길이와 글의 구조를 관찰했습니다.
강준형이 작성하고 최종 사실·코드·출처를 검토했습니다. 공개 자료와 작성자의 직접 기여를 구분하는 기준은 편집 원칙에서 확인할 수 있습니다.
함께 읽을 글
AI 개발자로서 신입분들에게 전하고 싶은 이야기
LangChain, LangGraph 기반 AI 개발 경험을 바탕으로 신입 개발자들에게 전하고 싶은 실무 팁과 마인드셋을 정리했습니다.
AI 에이전트의 진화: 프롬프트에서 컨텍스트 엔지니어링까지 (ACE를 곁들인)
GPT 등장 이후 AI 에이전트의 발전 흐름을 짚어보고, 모델 외부에서 성능을 향상시키는 최신 연구인 Agentic Context Engineering (ACE)을 소개합니다.
Agentic AI 개념 정리: 에이전트와 워크플로우의 스펙트럼
Agent, Workflow, Agentic AI의 개념을 정리하고, AI 엔지니어링 관점에서의 의의와 실제 적용 전략을 다룹니다.