JH'S TECH LOG
AI 에이전트와 LLM 시스템을 직접 만들고 검증하며 배운 판단을 기록합니다.
공식 문서의 단순 요약보다 재현 가능한 실험, 운영 중 실패한 선택, 실제로 바뀐 설계와 한계를 남깁니다.
Agent를 위한 온톨로지는 전사 데이터 모델에서 시작하지 않는다
전사 데이터를 먼저 온톨로지로 묶기보다 Agent가 실제로 답해야 할 질문에서 필요한 개념과 관계를 좁혀 간다. GraphRAG와 자동 구축을 어디까지 적용할지도 함께 정리했다.
최근 글
전체 글 보기
사내 AX 전담조직이 모든 Agent를 만들면 생기는 병목
중앙 AX팀이 업무별 Agent 구현까지 전부 소유하면 초기에는 빠르지만 운영 단계에서는 변경 대기열이 길어진다. 중앙팀과 업무조직이 각각 무엇을 소유해야 하는지 정리했다.
사용자 승인을 회수했지만 A2A Task는 계속 실행됐다
공식 A2A Python SDK 1.1.2로 서비스 승인 회수, 실행 중인 Task, 모의 ERP 쓰기가 자동으로 이어지지 않음을 재현했다. CancelTask와 외부 쓰기 직전 권한 검사는 서로 다른 제어였다.
나는 왜 새 Agent 서비스에 Router부터 두지 않는가
새 agent 프로젝트는 별도 Router나 Planner를 두기보다 primary agent 하나와 harness로 시작해 왔다. 반복되는 실패를 보고 agent 경계를 추가하는 기준을 정리했다.
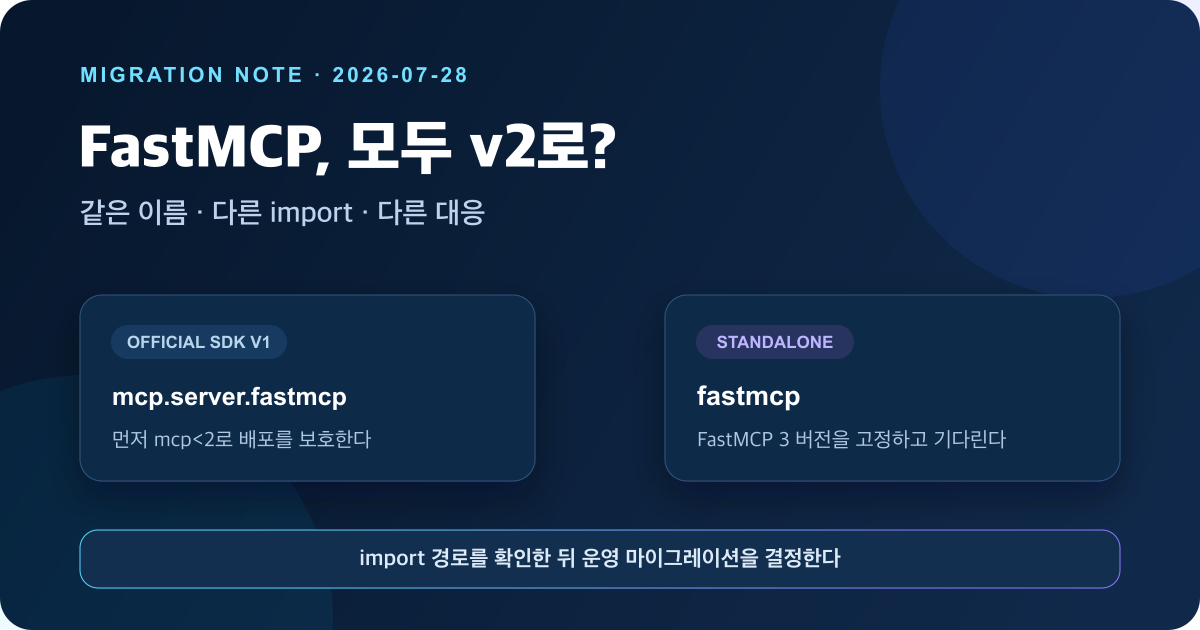
FastMCP 사용자라고 모두 MCP Python SDK v2로 옮겨야 하는 건 아니었다
공식 SDK의 FastMCP는 mcp<2로 막아야 했고, 별도 패키지인 FastMCP 3은 서두를 이유가 없었다. 두 import 경로를 나눈 뒤 호환성과 운영 전환 지점을 직접 확인했다.
7일간 29억 토큰을 처리하고도 371등: 자가개선 에이전트의 국소 최적점
Codex 하네스는 약 7일간 29억 토큰을 처리하며 스스로 작업 방식을 개선했다. 하지만 개선할수록 더 안전한 작은 일에 갇혔다.
코드를 덜 쓰고 규칙을 더 쓰는 시대: AI 코딩 어시스턴트 하네스 거버넌스 설계기
Cursor·Codex·Claude Code를 오가며 느낀 진짜 병목은 모델 성능보다 운영 모델의 불일치였다. 특히 skills 계층의 비대칭까지 포함해, 개인 취향과 팀 표준을 분리하는 실전 거버넌스 구조를 정리한다.
주요 프로젝트
직접 만들고 운영한 공개 프로젝트를 소개합니다.
프로젝트 포트폴리오
배포한 도구와 오픈소스 프로젝트의 문제·역할·검증 결과를 확인하세요.